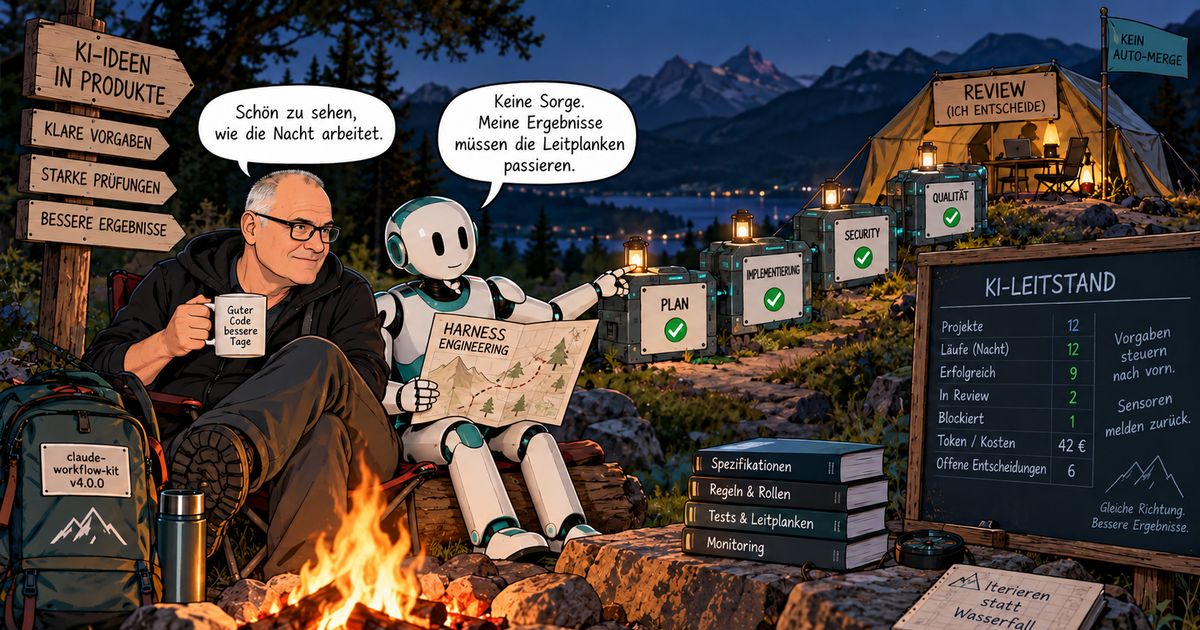
Heute habe ich Version 4.0.0 des claude-workflow-kit veröffentlicht. Bei der Gelegenheit habe ich mir angesehen, was der Markt inzwischen für KI-gestützte Entwicklung anbietet: GitHubs Spec Kit, OpenSpec, Kiro von AWS, BMAD, Copilot mit Agent HQ, Symphony von OpenAI, Devin und Cursor. Mein Eindruck ist, dass fast alle die vordere Hälfte bauen. Spezifikationen, Regeln, Rollen, Slash-Commands. Die hintere Hälfte, also das, was nach dem Modell prüft und im Zweifel blockiert, baut kaum jemand.
Birgitta Böckeler hat diese Unterscheidung im Februar auf martinfowler.com unter dem Begriff Harness Engineering beschrieben. Vorgaben steuern das Modell nach vorn, Sensoren melden zurück, ob das Ergebnis taugt. Mein Kit lebt von den Sensoren. Fünf Dinge kann es, die ich bei den anderen so nicht gefunden habe.
Die Nacht kann ihre eigenen Prüfungen nicht aufweichen
Jeder unbeaufsichtigte Lauf bindet sich beim Start an den letzten Push. Werkzeuge, Prüfungen, Skills und Regeltexte sind damit für die ganze Nacht eingefroren. Ändert ein Paket in derselben Nacht eine Prüfung, wirkt das erst, nachdem ich morgens push main getippt habe.
Ein Modell, das einen roten Test „repariert“, indem es die Prüfung lockert, kommt damit nicht durch. Das steht nicht als Bitte im Prompt. Das Werkzeug lässt es nicht zu.
Sechs Fragen halten an, alles andere wird entschieden
Kiro und Jules fragen nach, wenn sie unsicher sind. Welche Fragen das sein dürfen, legt dort niemand fest. In meinem Kit gibt es genau sechs Arten von Fragen, die eine Session anhalten: Datenverlust, Sicherheit, Verträge nach außen, ein Widerspruch im Fachplan, eine Änderung am Prozess und eine Abweichung vom fachlichen Anlass.
Alles andere entscheidet die Session selbst und schreibt die Entscheidung auf. Dazu gehören die verworfene Alternative, ein Grund und der Aufwand, die Entscheidung wieder zurückzubauen. Morgens lese ich Entscheidungen statt Rückfragen. Asana hat nach drei Monaten Spec-Driven Development beschrieben, wie das Review der Specs zum Engpass wurde. Genau diesen Engpass will ich vermeiden.
Autonomie ist eine Vollmacht an der Karte
Fast jedes Werkzeug am Markt kennt einen autonomen Modus. Bei mir ist Autonomie ein Label an einer einzelnen Karte. Setze ich kit:night an einen Fachplan, läuft genau eine Kette, und das Label wird beim Start verbraucht. Wie weit sie läuft, sagt ein Ziel-Label: bis zum Plan, bis zu den Arbeitspaketen, bis zur Umsetzung oder bis zum vorbereiteten Push.
Gepusht und gemergt wird nie automatisch. Je autonomer die KI arbeitet, desto klarer müssen die Stellen sein, an denen ich entscheide.
Ich messe, ob meine Leitplanken etwas taugen
Diesen Teil habe ich nirgends sonst gefunden. Für jede Pflichtprüfung weist das Kit aus, wie oft sie lief, wie oft sie etwas beanstandet hat und wie viel Zeit sie gekostet hat. Dazu kommt die Quote der Pakete, die aus „In review“ zurückwandern.
Eine Prüfung, die seit hundert Läufen nie angeschlagen hat, kostet mich nur Zeit. Eine Prüfung, die ständig anschlägt, zeigt mir, wo eine Leitplanke fehlt. Fehlende Werte stehen als „nicht gemessen“ da und nie als Null. Thoughtworks führt das Messen der Zusammenarbeitsqualität im aktuellen Technology Radar noch als Thema, das man sich ansehen sollte. Bei mir läuft es in jeder Nacht mit.
Fremde Modelle lesen den Plan, bevor Code entsteht
Ein Modell ist gegenüber der eigenen Lösung unkritisch. Deshalb lasse ich Fachplan und Plan von Modellen prüfen, die sie nicht geschrieben haben. Jedes bekommt eine feste Rolle, etwa Abgrenzung, Architektur gegen den Bestand oder Schnitt und Abhängigkeiten.
Jeder Fund muss sagen, welche Beobachtung ihn widerlegen würde und ob das Modell diese Gegenprobe gemacht hat. Ein Fund, den die eigene Gegenprobe widerlegt, wird gar nicht erst gemeldet. Reviews mit mehreren Modellen tauchen inzwischen auch bei den großen Anbietern auf, meistens für den Code. Den Plan prüft dort kaum jemand.
Der Leitstand zeigt mir die Nacht
Zum Kit gehört mein KI-Leitstand, ein selbst gehostetes Kanban-Board, das ich eher für Maschinen gebaut habe als für Menschen. Er zeigt jeden Lauf mit seinem Ausgang, je Arbeitspaket einen von vier Zuständen, Störungen über alle Projekte hinweg und Token und Kosten je Vorhaben. Lücken in der Erfassung stehen dort als Lücken.
Was die anderen besser können
Kiro arbeitet bis zu zehn Aufgaben parallel in isolierten Sandboxes, Copilot und Devin tun Ähnliches. Meine Nacht läuft auf meinem Rechner und arbeitet die Pakete nacheinander ab. Spec Kit und OpenSpec bedienen über dreißig Assistenten, mein Kit ist an Claude Code gebunden. Die Doku ist deutsch, und die Regeltexte sind über den Sommer schwer geworden.
Daran arbeite ich als Nächstes. Die Reviewer bekommen harte Grenzen und dürfen nur noch lesen. Unabhängige Pakete sollen parallel laufen, der Regeltext wird schlanker, und der Leitstand zeigt Kosten je Karte.
Das Kit und seine Doku stehen unter docs.mwolff.org, der Leitstand unter kanban.mwolff.org/docs.
Schreibe einen Kommentar