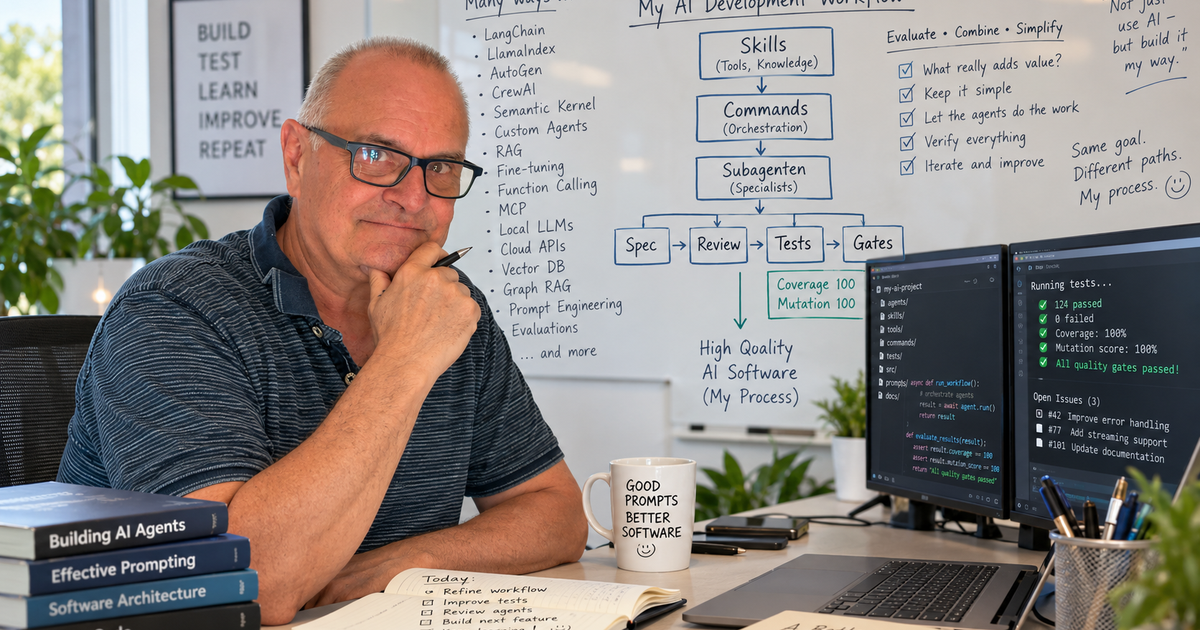
Fast jeder, den ich gerade treffe, baut seinen KI-Entwicklungsprozess selbst. Ich auch, und ich habe meinen gerade von Grund auf neu gebaut.
Die Ansätze sind dabei erstaunlich unterschiedlich. Die einen setzen auf Skills und Commands, die dem Modell für jede Situation ein Vorgehen mitgeben. Die anderen bauen Pipelines aus Subagenten, einer verfeinert die Aufgabe, einer codet, einer reviewt, einer testet. Wieder andere fangen bei der Spezifikation an und lassen alles Weitere daraus ableiten, mit Spec Kit, Kiro, BMAD oder OpenSpec (warum ich dabei das Pflichtenheft für einen Fehler halte, habe ich aufgeschrieben). Dazwischen liegen Hooks, Gates, Issue-Templates und jede Menge Skripte, die mit dem Modell selbst wenig zu tun haben.
Ich habe nachgelesen, ob sich in dieser Vielfalt ein Favorit abzeichnet. Die Vergleiche dieses Jahres kommen zum selben Ergebnis: Ein bestes Framework gibt es 2026 nicht. Eine Beratung empfiehlt nach drei Kundenprojekten sogar, zwei oder drei Frameworks zu mischen, statt sich auf eines festzulegen.
Warum ich das Selberbauen für richtig halte
Wer sein Framework selbst zusammensteckt, muss sich mit den echten Problemen beschäftigen. Wo geht Kontext verloren? Wann darf das Modell entscheiden und wann nicht? Welche Prüfung muss außerhalb des Modells liegen, weil das Modell gegenüber seiner eigenen Lösung unkritisch ist? Ein gekauftes Tool beantwortet diese Fragen für mich, und ich weiß hinterher nicht, ob die Antworten zu meiner Arbeit passen.
Aus demselben Grund gebe ich meine settings.json und meine Skill-Sammlungen nicht weiter. Eine fremde Konfiguration ist das Ergebnis ohne den Anlass. Jede Regel in meinem Prozess geht auf einen Vorfall zurück, den ich selbst erlebt habe. Wer nur die Regel übernimmt, hat den Vorfall nicht.
Bei den Schnittstellen ist der Standard schon da
Setzt sich irgendwann ein Standard durch? An den Rändern ist das längst passiert, und schneller, als ich dachte. Im Dezember 2025 hat Anthropic MCP an die Agentic AI Foundation unter dem Dach der Linux Foundation gegeben. OpenAI hat AGENTS.md beigesteuert, also die Datei, in der ein Repository seinem Agenten sagt, wie er sich zu verhalten hat. Neun Tage später wurden Agent Skills ein offener Standard, den inzwischen auch Codex, Gemini CLI, Copilot und Cursor lesen.
Standardisiert sind damit die Schnittstellen und die Behälter. Es ist geregelt, wie ein Werkzeug angebunden wird, wo die Anweisung liegt und wie ein Skill verpackt ist. Was drinsteht, regelt niemand. Was Claude Code darf, steht bei mir in einer Datei. Welche Regeln in dieser Datei stehen, bleibt meine Sache.
Warum ich beim Prozess nicht daran glaube
Der Prozess hängt von der Fehlerklasse ab, die das Modell produziert, und die verschiebt sich mit jeder Modellgeneration. Anthropic beschreibt das für die eigenen Agenten-Gerüste genauso: Jedes Gerüst steckt voller Annahmen darüber, was das Modell allein nicht kann, und diese Annahmen veralten, wenn das Modell besser wird. Das Claude-Code-Team geht bei jedem neuen Modell den System-Prompt durch und löscht die Ermahnungen, die das Modell nicht mehr braucht. Ein Werkzeug, das Claude Code davon abhalten sollte, ein Refactoring zu früh für fertig zu erklären, wurde überflüssig, als neuere Modelle mehrstufige Refactorings allein zu Ende brachten.
Kleiner wird das Gerüst dadurch nicht. Addy Osmani hat dafür die passende Beobachtung: Es wandert. Mit dem stärkeren Modell kommen Aufgaben in Reichweite, die vorher nicht gingen, und die bringen ihre eigenen Fehlermuster mit. Ein Prozessstandard, der heute verabschiedet wird, beschreibt die Schwächen eines Modells, das in einem halben Jahr abgelöst ist.
Ein Kern bleibt stehen
An dieser Stelle muss ich meine eigene Begründung genauer fassen. Es verschiebt sich nicht jede Fehlerklasse. Dass ein Modell gegenüber seiner eigenen Lösung unkritisch ist, hat sich über alle Generationen gehalten, mit denen ich gearbeitet habe. Dass es auf lokale Korrektheit optimiert und dabei die Architektur aus dem Blick verliert, ebenfalls.
Mein eigener Umbau zeigt dieselbe Trennlinie. Überlebt hat alles, bei dem am Ende ein Werkzeug entscheidet: Tests grün, Coverage 100, Mutation 100, Build grün. Gestorben ist der Apparat aus Reviewern, Synthese und Prüfung der Prüfung, den ich über den Sommer Vorfall für Vorfall aufgebaut hatte.
Ich sehe deshalb zwei Schichten. Der Kern besteht aus Gates, die außerhalb des Modells liegen, und aus Leitplanken, die scheitern können, statt zu argumentieren. Diesen Kern könnte man standardisieren. Neu ist er allerdings nicht, er stammt aus vierzig Jahren Software Engineering. Die Schale ist das Gerüst gegen die Schwächen der aktuellen Modellgeneration. Sie hat ein Verfallsdatum, und für etwas mit Verfallsdatum lohnt sich kein Standard.
Der Standard kommt über das Produkt
Wenn sich beim Prozess etwas durchsetzt, dann vermutlich ohne Gremium. Der Weg läuft über das Werkzeug. Jemand entdeckt im eigenen Gerüst einen Baustein, der trägt. Der Hersteller übernimmt ihn ins Produkt, die nächste Modellgeneration wird damit trainiert und kann ihn danach besser. Plan-Modus, Subagenten und Skills waren alle einmal Eigenbau, heute sind sie eingebaut.
Für mich ist das ein weiteres Argument für das Selberbauen. Was später Standard wird, entsteht heute in den Eigenbauten.
Wo meine Position endet
Zwei Grenzen sehe ich. Wer aus Kosten-, Datenschutz- oder Validierungsgründen bei einem festen Modell bleibt, für den dreht sich das Argument um. Sein Gerüst veraltet nicht, es bleibt tragend, solange das Modell dasselbe bleibt. Dort kann sich ein fertiger Prozess durchaus lohnen.
Die zweite Grenze ist das Team. Ich baue für mich allein. Ein Team mit zwanzig Leuten kann sich keine zwanzig Prozesse leisten. Selberbauen heißt dort, dass das Team einen Prozess baut und alle damit arbeiten, und dass jemand ihn pflegt wie Code.
Vielleicht irre ich mich, und in zwei Jahren arbeiten alle mit demselben Prozess. Dann schaue ich nach, welche meiner Regeln darin vorkommen.
Schreibe einen Kommentar